
RAG (Retrieval-Augmented Generation) là kỹ thuật kết hợp hai loại “bộ nhớ” trong một hệ thống AI: bộ nhớ tham số (kiến thức đã được huấn luyện sẵn vào mô hình ngôn ngữ) và bộ nhớ phi tham số (dữ liệu bên ngoài được truy xuất theo thời gian thực từ một chỉ mục, ví dụ tài liệu web hoặc cơ sở dữ liệu) — cho phép mô hình trả lời chính xác hơn, cập nhật hơn, và giảm hiện tượng “bịa thông tin” so với chỉ dựa vào kiến thức đã huấn luyện tĩnh.
Mình là Đăng, làm Search Marketing cho khách hàng B2B tại SME Solution đã 6 năm. RAG là khái niệm kỹ thuật nền tảng đứng sau gần như mọi AI search hiện nay — Perplexity, Gemini Grounding, Copilot, ChatGPT Search đều là các biến thể khác nhau của cùng một ý tưởng cốt lõi này. Hiểu đúng cơ chế RAG giúp bạn hiểu tại sao các nguyên tắc tối ưu nội dung cho AI search (đã phân tích trong các bài trước của loạt này) lại có lý — chứ không phải làm theo checklist một cách máy móc.
Cơ chế nguyên bản: paper gốc RAG (Lewis et al., 2020)
RAG lần đầu được trình bày trong paper “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” của Patrick Lewis và cộng sự, công bố tại hội nghị NeurIPS 2020, với các đồng tác giả từ Facebook AI Research (nay là Meta AI), University College London và New York University. Đây là nguồn gốc kỹ thuật thực sự của thuật ngữ đang được dùng phổ biến ngày nay.
Vấn đề paper này giải quyết: dù các mô hình ngôn ngữ tiền huấn luyện (pretrained language models) có khả năng lưu trữ một lượng lớn kiến thức trong tham số của chúng, khả năng truy cập và thao tác chính xác kiến thức đó vẫn bị hạn chế đáng kể, đặc biệt với các tác vụ đòi hỏi kiến thức chuyên sâu (knowledge-intensive tasks) như trả lời câu hỏi mở.
Giải pháp RAG đề xuất: kết hợp hai loại bộ nhớ —
- Bộ nhớ tham số (parametric memory) — một mô hình seq2seq đã được huấn luyện trước, lưu trữ kiến thức “ngầm” trong hàng tỷ tham số của nó.
- Bộ nhớ phi tham số (non-parametric memory) — một chỉ mục vector hóa từ Wikipedia (trong paper gốc), được truy cập thông qua một bộ truy xuất thần kinh (neural retriever) đã được huấn luyện trước.
Paper mô tả hai biến thể: một dùng cùng một đoạn trích đã truy xuất xuyên suốt toàn bộ chuỗi trả lời, biến thể còn lại cho phép dùng các đoạn trích khác nhau cho từng token được sinh ra — linh hoạt hơn nhưng phức tạp hơn về mặt tính toán.
Kết quả chính từ paper gốc — vì sao RAG được coi là bước ngoặt
Theo kết quả công bố, RAG đạt hiệu suất tiên tiến nhất (state-of-the-art) tại thời điểm đó trên ba tác vụ hỏi-đáp miền mở (open-domain question answering), vượt trội hơn cả các mô hình seq2seq thuần tham số lẫn các kiến trúc trích xuất-truy xuất chuyên biệt khác. Đặc biệt, ngôn ngữ do RAG sinh ra được đánh giá là “cụ thể hơn, đa dạng hơn và chính xác hơn” so với các mô hình chỉ dựa vào bộ nhớ tham số thuần túy — vì mô hình có thể “neo” câu trả lời vào bằng chứng thực tế thay vì chỉ dựa vào những gì đã “ghi nhớ” mơ hồ trong quá trình huấn luyện.
Chính đặc điểm này — khả năng neo câu trả lời vào bằng chứng truy xuất được, thay vì hoàn toàn dựa vào trí nhớ mô hình — là lý do RAG trở thành kỹ thuật nền tảng để giải quyết vấn đề “hallucination” (mô hình tự bịa thông tin nghe có vẻ hợp lý nhưng sai sự thật) vốn là hạn chế lớn nhất của các mô hình ngôn ngữ lớn thuần túy.
RAG giải quyết vấn đề gì — hai hạn chế cốt lõi của LLM thuần túy
Trước khi RAG phổ biến, mô hình ngôn ngữ lớn gặp hai vấn đề nghiêm trọng khi dùng độc lập:
- Kiến thức lỗi thời (knowledge cutoff) — mô hình chỉ “biết” những gì có trong dữ liệu huấn luyện tính đến một thời điểm nhất định, không thể tự cập nhật thông tin mới mà không huấn luyện lại toàn bộ (tốn kém và chậm).
- Hallucination (bịa thông tin) — khi được hỏi về điều mô hình không thực sự “biết” chắc chắn, nó có xu hướng tạo ra câu trả lời nghe hợp lý về mặt ngôn ngữ nhưng sai lệch về sự thật, vì bản chất mô hình dự đoán từ tiếp theo dựa trên xác suất, không phải tra cứu sự thật.
RAG giải quyết cả hai vấn đề bằng cách chèn thêm bước truy xuất thông tin thời gian thực trước khi mô hình sinh câu trả lời — mô hình không còn phải “nhớ” mọi thứ, chỉ cần biết cách tổng hợp thông tin đã được truy xuất sẵn, tương tự cách một người viết bài tra cứu tài liệu trước khi viết thay vì cố nhớ hết mọi chi tiết.
Vì sao RAG là nền tảng của mọi AI search hiện nay
Đây là điểm kết nối quan trọng nhất giữa lý thuyết học thuật và thực tiễn AI search mà doanh nghiệp B2B đang phải tối ưu cho: các hệ thống đã phân tích trong loạt bài này đều là biến thể ứng dụng của ý tưởng RAG gốc, dù mỗi hệ thống triển khai theo cách riêng:
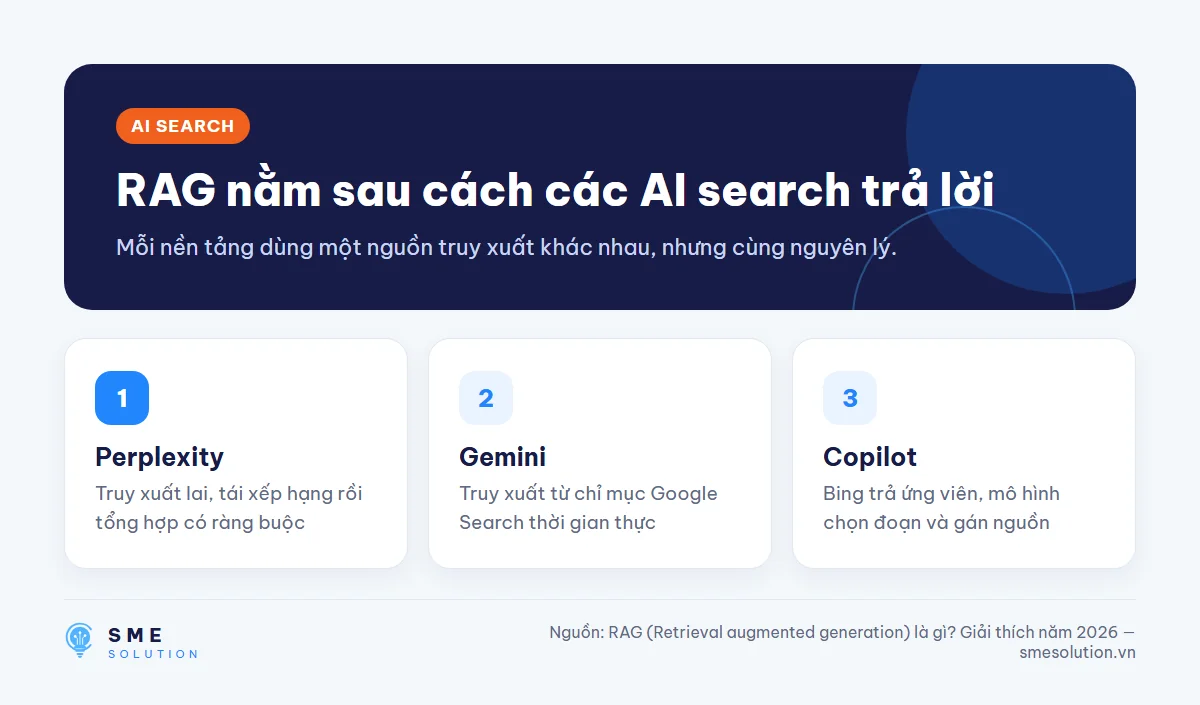
- Perplexity — pipeline truy xuất hybrid (BM25 + embedding), tái xếp hạng nhiều tầng, rồi tổng hợp câu trả lời bị ràng buộc bởi bằng chứng đã truy xuất — đúng cấu trúc RAG kinh điển, chỉ phức tạp hóa thêm bước rerank.
- Gemini (Grounding with Google Search) — bộ nhớ phi tham số ở đây chính là chỉ mục Google Search thời gian thực, thay vì Wikipedia tĩnh như paper gốc, nhưng nguyên lý kết hợp kiến thức mô hình với bằng chứng truy xuất được là giống hệt.
- Copilot — hai giai đoạn (Bing trả candidate, model tự chọn đoạn và viết câu trả lời có gán nguồn) chính là một dạng RAG áp dụng cho chỉ mục Bing.
Hiểu điều này giải thích tại sao các nguyên tắc tối ưu nội dung xuất hiện lặp lại xuyên suốt cả ba nền tảng đã phân tích trong bài so sánh cách ChatGPT, Gemini, Perplexity trích dẫn nguồn: đoạn văn dễ trích xuất độc lập, thông tin cụ thể có nguồn — không phải mẹo SEO ngẫu nhiên, mà là hệ quả trực tiếp từ cách kiến trúc RAG hoạt động ở tầng kỹ thuật gốc.
Framework: nội dung nào “thân thiện” với hệ thống RAG
Từ cơ chế RAG, có thể suy ra nguyên tắc viết nội dung nền tảng, áp dụng chung cho mọi AI search dựa trên RAG:
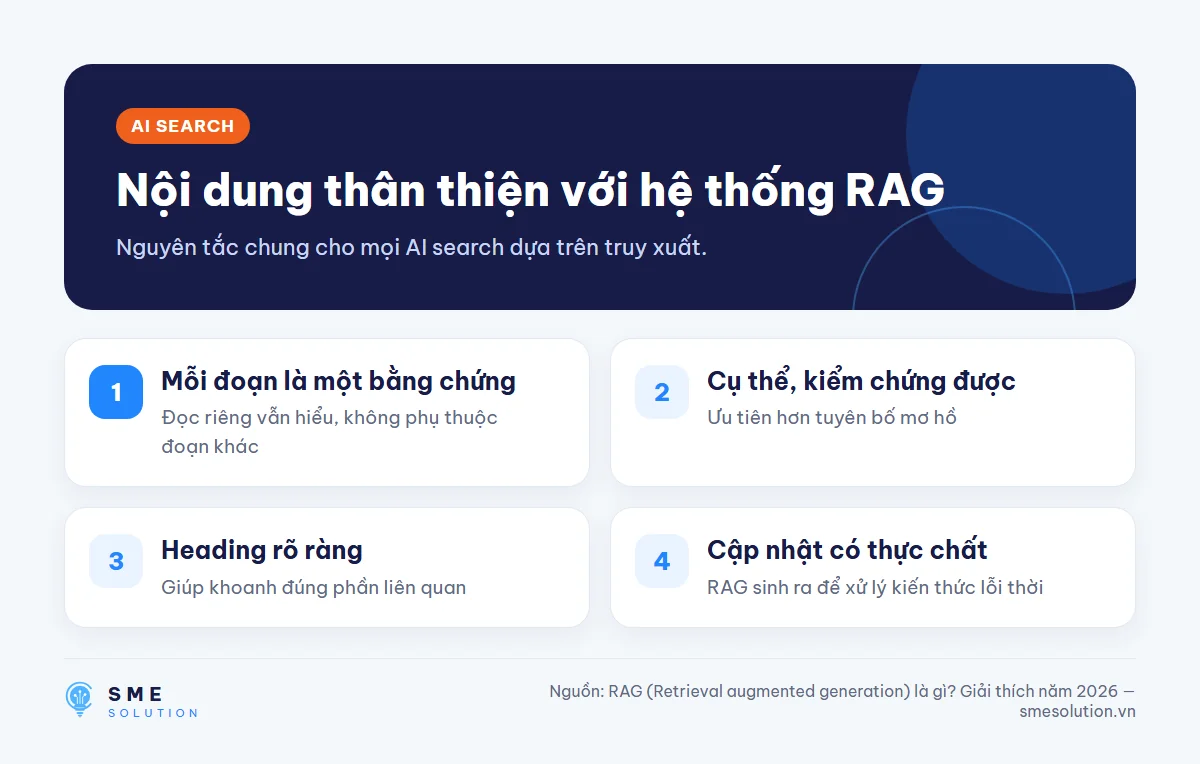
- Mỗi đoạn văn nên là một “đơn vị bằng chứng” độc lập — vì bước truy xuất trong RAG thường lấy từng đoạn (chunk) riêng lẻ, không phải toàn bộ tài liệu, một đoạn phụ thuộc ngữ cảnh đoạn trước để hiểu được sẽ khó được truy xuất chính xác.
- Thông tin cụ thể, có thể kiểm chứng được ưu tiên hơn tuyên bố mơ hồ — vì mục tiêu của RAG là giảm hallucination bằng cách neo vào bằng chứng thực, nội dung mơ hồ không cung cấp “bằng chứng” đủ mạnh để mô hình tự tin trích dẫn.
- Cấu trúc heading rõ ràng giúp bước truy xuất khoanh vùng đúng phần liên quan — hệ thống truy xuất hoạt động hiệu quả hơn khi tài liệu có cấu trúc rõ, giúp việc chia nhỏ thành các “chunk” để đánh chỉ mục giữ được ngữ nghĩa trọn vẹn.
- Cập nhật nội dung định kỳ có giá trị thực chất, không chỉ hình thức — vì RAG được thiết kế đặc biệt để giải quyết vấn đề kiến thức lỗi thời, nội dung phản ánh thông tin mới có lợi thế tự nhiên trong bất kỳ hệ thống nào dựa trên kiến trúc này.
Ví dụ minh họa: RAG giúp gì cho một câu hỏi B2B cụ thể
Nếu một khách hàng hỏi AI search “tiêu chuẩn hàn nào áp dụng cho kết cấu thép chịu lực tại Việt Nam năm 2026”, một mô hình ngôn ngữ thuần túy (không có RAG) chỉ có thể trả lời dựa trên kiến thức đã huấn luyện — có thể lỗi thời nếu tiêu chuẩn đã cập nhật, hoặc tệ hơn, có thể “bịa” ra một mã tiêu chuẩn nghe hợp lý nhưng không chính xác. Với RAG, hệ thống trước tiên truy xuất các tài liệu, trang web mới nhất về chủ đề này, rồi mới tổng hợp câu trả lời dựa trên bằng chứng vừa tìm được — nếu trang của một nhà cung cấp thép B2B có bài viết cập nhật, cụ thể, dễ trích xuất về đúng chủ đề này, nó có cơ hội trở thành một phần “bằng chứng” mà hệ thống RAG dùng để trả lời, và được gắn nguồn trực tiếp trong câu trả lời cuối.
Đây chính là cơ chế mà bọn mình dựa vào khi tư vấn chiến lược nội dung AI search cho khách hàng dùng dịch vụ SEO ở Hà Nội của SME Solution — không chỉ viết nội dung hay theo cảm tính, mà hiểu rõ tại sao một cấu trúc nội dung cụ thể lại có lợi thế trong hệ thống truy xuất mà các AI search hiện đại đang vận hành.
Câu hỏi thường gặp
RAG có phải công nghệ mới không?
Không hoàn toàn. Ý tưởng gốc được công bố từ năm 2020, khá lâu trước khi các AI search phổ biến như Perplexity hay ChatGPT Search ra đời. Điều mới trong giai đoạn 2023-2026 là việc triển khai RAG ở quy mô sản phẩm thương mại, phục vụ hàng trăm triệu người dùng, không phải bản thân ý tưởng kỹ thuật.
RAG khác gì so với việc mô hình chỉ được huấn luyện với dữ liệu mới hơn?
Huấn luyện lại mô hình với dữ liệu mới (fine-tuning hoặc re-training) tốn kém về thời gian và chi phí tính toán, không thể thực hiện liên tục theo thời gian thực. RAG giải quyết vấn đề tương tự (thông tin cập nhật) nhưng bằng cách truy xuất động tại thời điểm trả lời, không cần huấn luyện lại mô hình — nhanh hơn và linh hoạt hơn nhiều cho nhu cầu thông tin thời sự.
Doanh nghiệp B2B có cần tự xây hệ thống RAG riêng không?
Với mục tiêu tối ưu nội dung để được các AI search công khai (Perplexity, Gemini, ChatGPT) trích dẫn, không cần tự xây RAG riêng — chỉ cần hiểu cơ chế để viết nội dung phù hợp. Việc tự xây hệ thống RAG nội bộ (ví dụ chatbot hỗ trợ khách hàng dựa trên tài liệu công ty) là một nhu cầu kỹ thuật khác, không thuộc phạm vi tối ưu SEO/AI search.
Đọc paper gốc có cần thiết cho người làm content/SEO không?
Không bắt buộc phải đọc toàn bộ paper kỹ thuật, nhưng hiểu đúng cơ chế cốt lõi (kết hợp bộ nhớ tham số và truy xuất bằng chứng ngoài) giúp lý giải được vì sao các nguyên tắc viết nội dung cho AI search lại có cơ sở kỹ thuật vững chắc, thay vì chỉ làm theo checklist mà không hiểu bản chất.
Nguồn tham khảo
Muốn hiểu rõ hơn cách áp dụng cơ chế RAG vào chiến lược nội dung của bạn?
Nhắn Zalo cho SME Solution nếu bạn muốn bọn mình cùng rà lại nội dung hiện tại — xem cấu trúc đoạn văn có đang phù hợp với cách các hệ thống RAG (Perplexity, Gemini, Copilot) truy xuất và trích dẫn hay chưa.

