

Tối ưu nội dung cho Perplexity là quá trình định dạng và cấu trúc nội dung để vượt qua pipeline chọn nguồn 6 bước của Perplexity — từ truy xuất hybrid (kết hợp từ khóa và embedding ngữ nghĩa) đến tái xếp hạng nhiều tầng — nhằm lọt vào nhóm 3-4 nguồn được trích dẫn trực tiếp trong câu trả lời, thay vì bị loại khỏi 5-10 ứng viên ban đầu.
Mình là Đăng, làm Search Marketing cho khách hàng B2B tại SME Solution đã 6 năm. Trước đây tối ưu nội dung chỉ cần nhắm đúng từ khóa và thứ hạng Google, nhưng Perplexity vận hành theo một logic hoàn toàn khác — không có “vị trí #1”, chỉ có được trích dẫn hoặc không. Trong bài này mình sẽ đi từ cơ chế kỹ thuật thật của Perplexity (không phải suy đoán) đến cách viết nội dung thực chiến để tăng cơ hội được chọn.
Perplexity là gì và vì sao doanh nghiệp B2B nên quan tâm
Perplexity là công cụ tìm kiếm trả lời trực tiếp (answer engine), khác Google ở chỗ nó không trả về danh sách 10 link xanh mà tổng hợp câu trả lời từ nhiều nguồn, kèm trích dẫn rõ ràng ngay trong câu trả lời. Với B2B, đây là kênh đáng chú ý vì người mua ở giai đoạn nghiên cứu ban đầu — so sánh nhà cung cấp, tìm hiểu khái niệm kỹ thuật — ngày càng dùng các công cụ dạng này thay vì gõ từ khóa vào Google rồi tự đọc từng trang.
Cơ chế: pipeline 6 bước Perplexity dùng để chọn nguồn trích dẫn
Đây là phần ít bài tiếng Việt giải thích đến tận gốc. Theo tài liệu kỹ thuật công khai và phân tích cơ chế retrieval của Perplexity, quy trình xử lý một truy vấn diễn ra qua 6 bước nối tiếp:

- Phân tích ý định truy vấn (query intent parsing) — hệ thống xác định người dùng đang hỏi gì, cần loại câu trả lời nào (định nghĩa, so sánh, số liệu, hướng dẫn).
- Truy xuất web thời gian thực bằng phương pháp hybrid — kết hợp BM25 (so khớp từ khóa truyền thống) với dense embeddings (tìm kiếm theo ý nghĩa ngữ nghĩa), lấy về khoảng 5-10 trang ứng viên ban đầu.
- Xếp hạng đa lớp bằng machine learning — một bộ tái xếp hạng (reranker) ba tầng đánh giá lại độ liên quan của từng ứng viên, không chỉ dựa vào điểm truy xuất ban đầu.
- Lắp ráp prompt có cấu trúc — các đoạn trích từ nguồn được chọn lọc và gắn sẵn citation, chuẩn bị đưa vào mô hình ngôn ngữ.
- Tổng hợp bằng LLM có ràng buộc bởi bằng chứng đã truy xuất — mô hình chỉ được phép trả lời dựa trên nội dung đã truy xuất ở bước trên, không tự bịa.
- Trả về câu trả lời với 3-4 nguồn trích dẫn — trong số 5-10 ứng viên ban đầu, chỉ một phần nhỏ “sống sót” qua toàn bộ pipeline để xuất hiện trong câu trả lời cuối.
Ý nghĩa thực chiến: một trang có thể xuất hiện trong 10 kết quả tìm kiếm Google nhưng vẫn bị loại ở bước 3 (rerank) nếu nội dung không đủ “trích xuất được” — tức không có đoạn văn độc lập, rõ ràng mà hệ thống có thể lấy ra nguyên vẹn để dùng làm bằng chứng.
PerplexityBot và Perplexity-User: hai bot khác nhau hoàn toàn
Đây là điểm nhiều bài hướng dẫn tối ưu Perplexity bỏ sót, nhưng ảnh hưởng trực tiếp đến chiến lược robots.txt của bạn. Perplexity vận hành hai loại crawler tách biệt, theo tài liệu chính thức tại docs.perplexity.ai:
- PerplexityBot — crawler tổng quát, thu thập nội dung để xây dựng chỉ mục phục vụ câu trả lời cho tất cả người dùng sau này. Bot này tuân thủ robots.txt — nếu bạn chặn, nội dung sẽ không có mặt trong chỉ mục của Perplexity.
- Perplexity-User — không phải crawler theo nghĩa thông thường, mà là hành động truy cập trang web theo thời gian thực khi một người dùng cụ thể đặt câu hỏi cần thông tin từ trang đó. Vì đây là hành động do người dùng khởi tạo trực tiếp (giống việc một người copy URL vào trình duyệt), Perplexity-User thường bỏ qua quy tắc robots.txt.
Hệ quả thực tế: nếu bạn chặn PerplexityBot để tránh bị “crawl” nhưng vẫn muốn xuất hiện khi người dùng hỏi trực tiếp về trang của bạn, việc chặn robots.txt không đảm bảo ngăn được hoàn toàn — vì Perplexity-User hoạt động theo cơ chế khác. Ngược lại, nếu bạn muốn được đưa vào chỉ mục chung (xuất hiện cho nhiều truy vấn khác nhau, không chỉ khi có ai hỏi trực tiếp về bạn), bạn cần cho phép PerplexityBot.
5 yếu tố quyết định một trang có được trích dẫn hay không
Dựa trên cách pipeline lọc nguồn vận hành, có 5 tiêu chí một trang cần vượt qua liên tiếp:
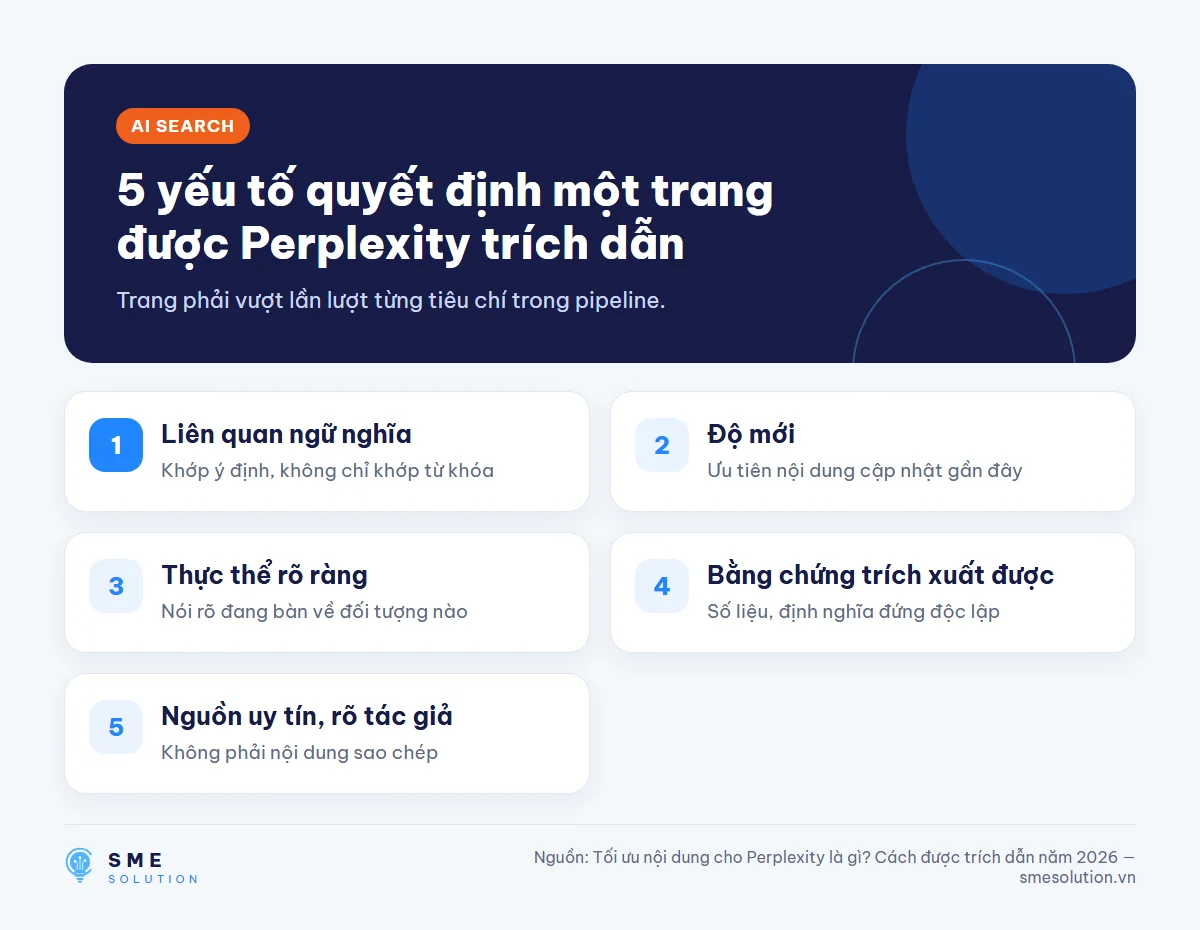
- Độ liên quan ngữ nghĩa (semantic relevance) — nội dung phải khớp đúng ý định truy vấn, không chỉ khớp từ khóa bề mặt.
- Độ mới (freshness) — nội dung cập nhật gần đây được ưu tiên hơn, đặc biệt với truy vấn có tính thời sự; Perplexity có thể trích dẫn nội dung mới xuất bản chỉ trong vài giờ nếu đạt chuẩn chất lượng.
- Độ rõ ràng của thực thể (entity clarity) — trang phải xác định rõ ràng mình đang nói về thực thể nào (sản phẩm, công ty, khái niệm cụ thể), không mơ hồ.
- Bằng chứng có thể trích xuất (extractable evidence) — có đoạn văn, số liệu, định nghĩa đứng độc lập, dễ lấy ra nguyên vẹn mà không mất ngữ cảnh.
- Uy tín nguồn và attribution sạch — trang có nguồn gốc rõ ràng, tác giả xác định, không phải nội dung sao chép hàng loạt.
Một trang cấu trúc dễ trích xuất — có định nghĩa rõ ràng, phần được đánh dấu tiêu đề, câu tóm tắt có thể trích dẫn độc lập, các khối bằng chứng đứng riêng — đóng góp nhiều hơn vào câu trả lời được tạo ra, so với trang đòi hỏi hệ thống truy xuất phải tự ghép nối ý nghĩa từ các đoạn văn dày đặc.
Cách viết nội dung để tối ưu cho pipeline này
Từ 5 yếu tố trên, có thể suy ra một khung viết thực chiến:
- Mở đầu mỗi phần bằng câu trả lời trực tiếp — đừng dẫn dắt dài dòng trước khi vào ý chính; đặt định nghĩa hoặc câu trả lời ngay đầu đoạn để hệ thống dễ trích xuất nguyên câu.
- Tách bạch từng ý thành đoạn độc lập — mỗi đoạn nên tự đứng vững về nghĩa, không phụ thuộc vào đoạn trước để hiểu được, vì retrieval có thể chỉ lấy một đoạn, không lấy cả bài.
- Dùng số liệu có nguồn cụ thể, không nói chung chung — “giảm 30% chi phí” yếu hơn “giảm 30% chi phí vận hành trong 6 tháng, theo khảo sát nội bộ 40 khách hàng B2B ngành cơ khí năm 2026”.
- Cập nhật nội dung định kỳ — vì freshness là một tiêu chí lọc trực tiếp, bài viết cũ không cập nhật sẽ dần mất lợi thế dù nội dung vẫn đúng về mặt kỹ thuật.
- Ghi rõ tác giả và nguồn gốc thông tin — góp phần vào tiêu chí attribution sạch, đặc biệt quan trọng với nội dung B2B kỹ thuật nơi độ tin cậy tác giả ảnh hưởng trực tiếp đến việc hệ thống có coi đây là nguồn đáng trích dẫn hay không.
Một ví dụ cụ thể: một bài viết về “thời gian bảo trì máy nén khí công nghiệp” nếu chỉ viết chung chung “cần bảo trì định kỳ” sẽ khó được trích dẫn hơn một bài nêu rõ “bảo trì định kỳ mỗi 2.000 giờ vận hành hoặc 3 tháng, tùy điều kiện nào đến trước — theo khuyến cáo nhà sản xuất” — vì câu sau vừa cụ thể, vừa tự đứng vững như một bằng chứng độc lập mà hệ thống có thể trích xuất nguyên vẹn.
Perplexity khác gì so với việc tối ưu cho Google AI Overviews truyền thống
Nhiều đội ngũ content áp dụng nguyên xi checklist tối ưu AI Overviews sang cho Perplexity và thất vọng vì kết quả không như kỳ vọng. Khác biệt cốt lõi: AI Overviews của Google dựa trên chỉ mục Google Search sẵn có (một trang đã rank tốt có lợi thế), trong khi Perplexity vận hành hệ thống retrieval và rerank độc lập, không phụ thuộc hoàn toàn vào thứ hạng Google. Điều này có nghĩa: một trang chưa rank cao trên Google vẫn có cơ hội được Perplexity trích dẫn nếu nội dung đủ cụ thể, dễ trích xuất và mới — và ngược lại, một trang rank tốt trên Google không tự động được Perplexity chọn nếu cấu trúc không phù hợp với pipeline retrieval của nó.
Với B2B, đây là cơ hội thực sự cho các domain còn non trẻ: thay vì phải cạnh tranh authority tổng thể như trên Google, bạn có thể thắng ở từng câu trả lời cụ thể nếu nội dung đáp ứng đúng 5 tiêu chí trên. Đây cũng là lý do trong dịch vụ SEO Hà Nội của SME Solution, bọn mình luôn đưa checklist “khả năng trích xuất” vào quy trình audit nội dung cho khách hàng B2B, song song với audit SEO truyền thống.
Framework tự đánh giá: nội dung của bạn có “thân thiện” với Perplexity không
Dùng 5 câu hỏi sau để tự chấm nội dung trước khi xuất bản:
- Nếu chỉ trích một đoạn duy nhất trong bài, đoạn đó có tự đủ nghĩa để trả lời câu hỏi chính không?
- Có ít nhất một số liệu cụ thể kèm nguồn/thời điểm trong 500 từ đầu không?
- Bài có ghi rõ ngày cập nhật gần nhất và có thực sự được cập nhật không?
- Thực thể chính (sản phẩm/công ty/khái niệm) có được nêu tên rõ ràng, nhất quán xuyên suốt bài, không dùng đại từ mơ hồ?
- Tác giả và nguồn gốc thông tin có được ghi rõ, kiểm chứng được không?
Nếu một bài trả lời “không” cho từ 2 câu trở lên, khả năng cao nội dung sẽ bị loại ở bước rerank dù chủ đề đúng và từ khóa khớp.
Câu hỏi thường gặp
Perplexity có tính là nguồn traffic đáng kể cho B2B chưa?
Tùy ngành và tệp khách hàng. Với B2B kỹ thuật/công nghiệp, lượng truy vấn qua Perplexity còn nhỏ hơn Google nhiều lần, nhưng đang tăng nhanh và có xu hướng đến từ nhóm ra quyết định (không phải người dùng phổ thông), nên giá trị mỗi lượt truy cập có thể cao hơn.
Có cần viết nội dung riêng cho Perplexity không, hay tối ưu chung được?
Không cần viết riêng hoàn toàn — nội dung tối ưu tốt cho Perplexity (đoạn độc lập, số liệu cụ thể, cập nhật thường xuyên) cũng có lợi cho SEO truyền thống và các AI search khác. Khác biệt chủ yếu nằm ở cách cấu trúc đoạn văn để dễ trích xuất, không phải viết lại toàn bộ chiến lược content.
Chặn PerplexityBot có ảnh hưởng gì đến SEO Google không?
Không. PerplexityBot và Googlebot là hai crawler hoàn toàn độc lập, không liên quan đến nhau. Chặn PerplexityBot chỉ ảnh hưởng đến việc nội dung có được Perplexity index hay không.
Nguồn tham khảo
- Perplexity Crawlers — tài liệu chính thức
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., 2020) — arXiv
Bạn đang cân nhắc tối ưu nội dung cho AI search?
Nếu bạn muốn audit lại nội dung hiện có xem có đáp ứng được các tiêu chí trích xuất của Perplexity và các AI search khác hay không, nhắn Zalo cho SME Solution — bọn mình sẽ xem qua vài trang cụ thể và chỉ ra điểm cần điều chỉnh trước khi bạn quyết định đầu tư thêm.

