
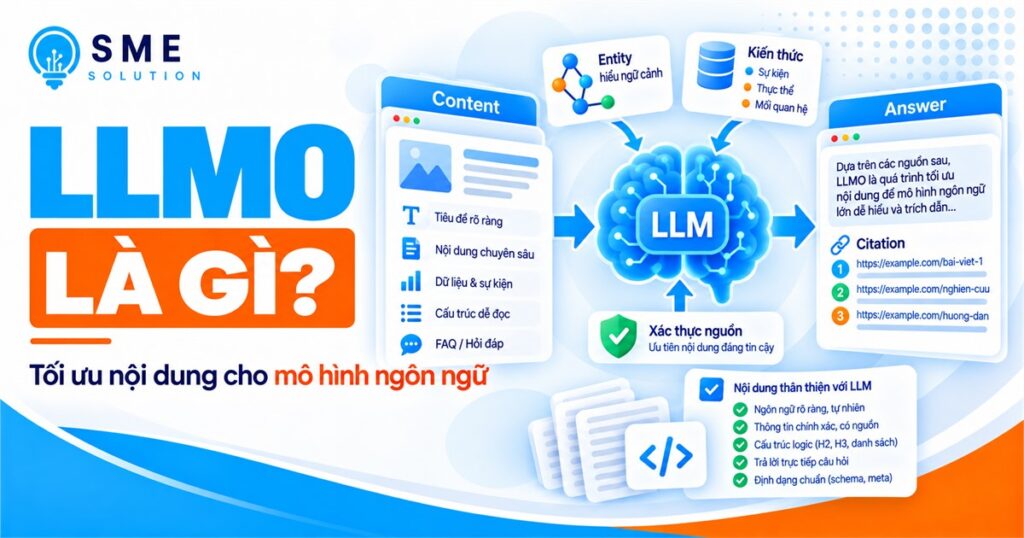
LLMO (Large Language Model Optimization) là việc tối ưu nội dung và website để tăng khả năng được các mô hình ngôn ngữ lớn — như ChatGPT, Claude, Gemini — hiểu, tái sử dụng và trích dẫn khi tạo câu trả lời cho người dùng.
Mình là Đăng, làm Search Marketing cho khách hàng B2B tại SME Solution đã 6 năm. Bài này mình sẽ chỉ ra điểm khác biệt cốt lõi giữa LLMO và SEO truyền thống: LLMO ưu tiên sự rõ ràng về ý nghĩa hơn là các tín hiệu SEO cổ điển.
LLMO là gì?
LLMO tập trung vào việc tạo ra nội dung mà các hệ thống AI có thể dễ dàng hiểu, tái sử dụng và tham chiếu — mục tiêu là được trích dẫn, tóm tắt, hoặc dùng làm nguồn trong các câu trả lời do AI tạo ra, áp dụng cho các nền tảng phổ biến như ChatGPT, Claude, Gemini.
LLMO khác SEO truyền thống ở đâu
Đây là khác biệt quan trọng nhất cần nắm.
SEO truyền thống ưu tiên các tín hiệu như mật độ từ khóa, số lượng và chất lượng backlink, cấu trúc URL. LLMO ưu tiên sự rõ ràng về ý nghĩa (clarity) hơn là các tín hiệu SEO cổ điển — một mô hình ngôn ngữ không “đếm từ khóa” theo cách công cụ tìm kiếm truyền thống làm, mà cố gắng hiểu ý nghĩa và ngữ cảnh của nội dung để quyết định có dùng nó làm nguồn hay không. Cấu trúc dễ đọc bằng máy — như bảng, danh sách, định nghĩa rõ ràng — giúp AI trích xuất và tái sử dụng thông tin chính xác hơn nhiều so với văn bản dày đặc, mơ hồ.
Cơ chế thật: RAG mới là đòn bẩy, không phải training data
Một hiểu lầm phổ biến khi mới tiếp cận LLMO là nghĩ mục tiêu là “lọt vào dữ liệu huấn luyện” của ChatGPT hay Gemini. Về mặt lý thuyết điều này khả thi, nhưng ở quy mô hoàn toàn không thực tế với phần lớn doanh nghiệp — và quan trọng hơn, kết quả không thể kiểm soát được (không ai biết chắc nội dung nào sẽ được mô hình “nhớ” và dùng lại ra sao sau khi huấn luyện).
Đòn bẩy thực tế mà LLMO nên tập trung vào là RAG (Retrieval-Augmented Generation) — cơ chế các mô hình ngôn ngữ dùng để truy xuất thông tin từ nguồn bên ngoài (web, cơ sở dữ liệu) tại thời điểm trả lời, thay vì chỉ dựa vào những gì đã “học” lúc huấn luyện. Đây chính là lý do một trang mới đăng vẫn có thể được ChatGPT trích dẫn ngay, dù mô hình chưa từng “thấy” trang đó lúc huấn luyện — vì hệ thống đang truy xuất trực tiếp, không phải nhớ lại.
Hệ quả thực tế quan trọng: với ChatGPT, phần lớn khả năng truy xuất web dựa trên chỉ mục của Bing — nghĩa là tối ưu thứ hạng trên Bing Search có tác động trực tiếp đến khả năng được ChatGPT trích dẫn. Với Gemini và Google AI Overviews, cơ chế tương tự áp dụng với chỉ mục Google Search. Nói cách khác, thứ hạng tìm kiếm truyền thống cao thường kéo theo khả năng hiển thị trên chatbot cao — nền tảng SEO kỹ thuật vững vẫn là điều kiện tiên quyết, không thể bỏ qua để “nhảy thẳng” vào LLMO.
Dữ liệu thực tế: nguồn nào đang được các mô hình ưu tiên trích dẫn
Theo phân tích của Profound trên hơn 680 triệu lượt trích dẫn trên ChatGPT, Google AI Overviews và Perplexity (giai đoạn 8/2024–6/2025), có sự khác biệt rõ rệt về nguồn ưu tiên giữa các nền tảng: Wikipedia chiếm khoảng 47,9% thị phần nguồn trong top 10 kết quả của ChatGPT, trong khi Reddit chiếm khoảng 46,7% thị phần nguồn trong top 10 của Perplexity — hai nền tảng có xu hướng ưu tiên nguồn rất khác nhau dù cùng là “AI search“. Khác biệt này cho thấy tối ưu cho một nền tảng AI không đảm bảo hiệu quả tương tự trên nền tảng khác.
Một điểm khác đáng lưu ý cho chiến lược nội dung: ChatGPT thường nhắc tên thương hiệu trong câu trả lời mà không kèm link nguồn. Điều này có nghĩa: đo lường “AI visibility” chỉ dựa vào số lượt click/referral traffic sẽ bỏ sót phần lớn giá trị thực sự — phần lớn giá trị nằm ở việc thương hiệu được nhắc đến và ghi nhớ trong câu trả lời, dù người dùng không click qua website.
Cách tối ưu nội dung theo LLMO

- Viết định nghĩa rõ ràng, súc tích cho mọi khái niệm quan trọng — mô hình ngôn ngữ ưu tiên trích dẫn các câu định nghĩa ngắn gọn, chính xác.
- Dùng bảng và danh sách cho dữ liệu có cấu trúc (thông số kỹ thuật, so sánh) — dễ trích xuất hơn nhiều so với đoạn văn dài mô tả cùng thông tin.
- Đảm bảo thực thể (entity) rõ ràng, nhất quán — tên thương hiệu, sản phẩm được nhắc đến nhất quán giúp mô hình liên kết đúng thông tin với đúng thực thể.
- Khai báo schema markup — dữ liệu có cấu trúc là tín hiệu rõ ràng nhất giúp máy đọc chính xác nội dung, không cần suy luận.
- Ưu tiên nội dung gốc, dữ liệu độc quyền — các mô hình ngôn ngữ có xu hướng ưu tiên nguồn có thông tin mới, không lặp lại những gì đã có ở nhiều nơi khác.
Đơn vị tối ưu đã thay đổi: từ URL sang từng câu trả lời cụ thể
Một thay đổi tư duy quan trọng mà LLMO đòi hỏi: SEO truyền thống coi mỗi URL là một đơn vị cạnh tranh — trang A xếp hạng cao hơn trang B cho một từ khóa. LLMO không hoạt động theo logic đó. Đơn vị cạnh tranh thực sự trong LLMO là từng câu trả lời cụ thể trong đầu ra của mô hình — một trang có thể được trích dẫn cho câu hỏi này nhưng hoàn toàn vắng mặt ở câu hỏi liên quan chỉ khác cách diễn đạt. Hệ quả: nghiên cứu từ khóa cho LLMO cần mở rộng ra nhiều biến thể câu hỏi thực tế (từ mục “Mọi người cũng hỏi”, phỏng vấn khách hàng, các câu hỏi tiếp nối tự nhiên trong hội thoại), thay vì chỉ nhắm một cụm từ khóa chính duy nhất như cách làm SEO truyền thống vẫn quen thuộc.
Một lưu ý thực tế từ giới nghiên cứu LLMO: chủ đề càng bão hòa (nhiều nguồn cùng viết) hoặc câu hỏi càng mơ hồ, kết quả trích dẫn càng biến động thất thường ngày qua ngày — nghĩa là chiến lược tối ưu từng câu trả lời đơn lẻ khó bền vững bằng việc xây dựng độ sâu và độ tin cậy tổng thể cho cả một chủ đề.
Biến động thực tế: nguồn trích dẫn có thể thay đổi đột ngột
Dữ liệu theo dõi thực tế cho thấy thứ hạng nguồn trên các nền tảng AI có thể biến động mạnh trong thời gian ngắn — không ổn định như thứ hạng SEO truyền thống vốn thay đổi từ từ. Ví dụ, theo nghiên cứu của Semrush trên hơn 230.000 prompt (7–10/2025), tỷ lệ câu trả lời ChatGPT có trích Reddit giảm đột ngột từ gần 60% đầu tháng 8 xuống khoảng 10% vào giữa tháng 9/2025, còn Wikipedia giảm từ khoảng 55% xuống dưới 20% — sau đó hai nguồn này ổn định lại ở mức cân bằng hơn và vẫn là hai domain được ChatGPT trích nhiều nhất. Điều này cho thấy: nguồn trích dẫn AI đang phụ thuộc vào các thay đổi thuật toán nội bộ diễn ra thường xuyên và khó dự đoán hơn nhiều so với thuật toán xếp hạng tìm kiếm truyền thống — doanh nghiệp làm LLMO cần chấp nhận mức độ biến động này như một đặc điểm cố hữu, không phải dấu hiệu chiến lược sai.
Sai lầm thường gặp
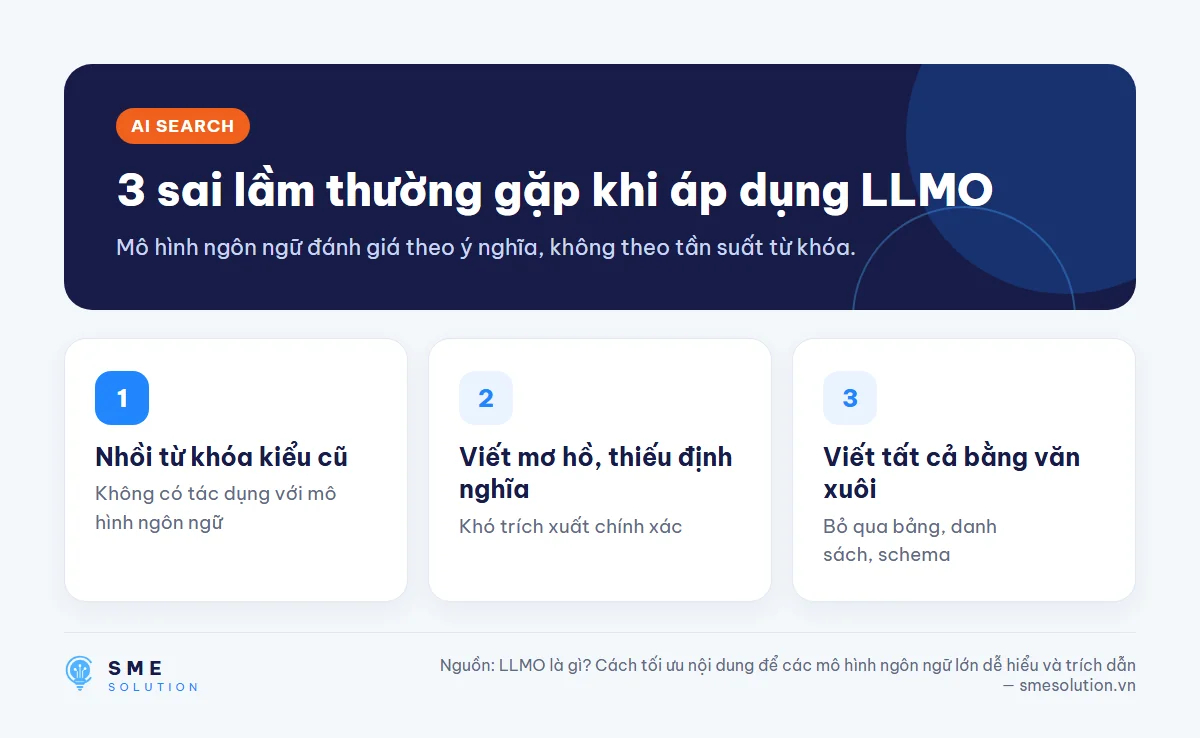
- Áp dụng nguyên tắc SEO cổ điển (nhồi từ khóa) vào LLMO — không có tác dụng, vì mô hình ngôn ngữ đánh giá theo ý nghĩa, không theo tần suất từ khóa.
- Viết nội dung mơ hồ, thiếu định nghĩa rõ ràng — khó để mô hình ngôn ngữ trích xuất chính xác để trích dẫn.
- Bỏ qua cấu trúc dữ liệu (bảng, danh sách, schema) khi trình bày thông tin có thể cấu trúc hóa được, viết tất cả dưới dạng văn xuôi.
FAQ
LLMO có phải chỉ áp dụng cho ChatGPT không?
Không — LLMO áp dụng chung cho mọi mô hình ngôn ngữ lớn phổ biến, bao gồm ChatGPT (OpenAI), Claude (Anthropic), và Gemini (Google), dù mỗi nền tảng có thể có ưu tiên nguồn hơi khác nhau — dữ liệu cho thấy Wikipedia và Reddit là hai nguồn dẫn đầu nhưng với tỷ trọng khác nhau đáng kể giữa ChatGPT và Perplexity, nên chiến lược nội dung nên tính đến sự khác biệt này thay vì coi mọi nền tảng AI là giống hệt nhau khi lên kế hoạch phân bổ nguồn lực.
LLMO khác GEO ở điểm nào?
Hai khái niệm có nhiều điểm chung và thường được dùng thay thế cho nhau trong thực tế. Nếu phân biệt chặt chẽ, GEO thường nhấn mạnh việc tối ưu cho công cụ tìm kiếm dùng AI sinh tạo (như Google AI Overviews), còn LLMO nhấn mạnh việc tối ưu cho chính mô hình ngôn ngữ nói chung, kể cả khi không gắn với ngữ cảnh tìm kiếm.
Có cần bỏ SEO truyền thống để làm LLMO không?
Không — nền tảng technical SEO (crawl, index tốt) vẫn là điều kiện cần để nội dung được các mô hình ngôn ngữ tiếp cận được ngay từ đầu. LLMO bổ sung thêm lớp tối ưu về rõ ràng ý nghĩa, không thay thế nền tảng đó.
Tối ưu cho Bing có thực sự quan trọng với ChatGPT không?
Có — vì phần lớn khả năng truy xuất web thời gian thực của ChatGPT dựa trên chỉ mục của Bing Search, thứ hạng tốt trên Bing thường kéo theo khả năng được ChatGPT trích dẫn cao hơn. Đây là điểm nhiều doanh nghiệp Việt Nam bỏ qua vì quen tập trung hoàn toàn vào Google, trong khi Bing vẫn đóng vai trò hạ tầng quan trọng cho AI search — kiểm tra Bing Webmaster Tools định kỳ là bước đơn giản nhưng thường bị bỏ sót trong quy trình SEO hiện tại của nhiều doanh nghiệp B2B Việt Nam.
Vì sao thứ hạng trích dẫn AI lại biến động nhiều hơn thứ hạng SEO?
Vì các nền tảng AI thường xuyên điều chỉnh thuật toán truy xuất và tổng hợp nguồn ở tần suất cao hơn nhiều so với chu kỳ cập nhật thuật toán xếp hạng tìm kiếm truyền thống, cộng thêm việc mỗi câu trả lời được tạo mới theo thời gian thực (không lưu cache cố định như trang kết quả tìm kiếm) khiến nguồn trích dẫn có thể thay đổi ngay cả khi nội dung nguồn không hề thay đổi. Doanh nghiệp nên chấp nhận theo dõi định kỳ (hàng tháng) thay vì kỳ vọng một lần tối ưu sẽ giữ nguyên vị trí lâu dài như cách SEO truyền thống từng vận hành.
Nguồn tham khảo
- Conductor, “LLMO (Large Language Model Optimization)”
- Evergreen, “Large Language Model Optimization (LLMO) explained”
- Profound, “AI Platform Citation Patterns” (6/2025)
- Semrush, “The Most-Cited Domains in AI: A 3-Month Study” (11/2025)
- 5WPR, “The state of AI citations 2026 research report” (trang tổng hợp)
Muốn nội dung B2B kỹ thuật của bạn được ChatGPT và các mô hình AI khác hiểu đúng và trích dẫn? Dịch vụ SEO tại Hà Nội của SME Solution có bước tối ưu LLMO riêng cho nội dung kỹ thuật phức tạp.

