


Quản lý AI crawler qua robots.txt là việc thêm các directive User-agent và Disallow/Allow riêng cho từng bot AI (GPTBot, ClaudeBot, PerplexityBot, Google-Extended…) vào file robots.txt ở thư mục gốc website — nhưng khác với robots.txt truyền thống chỉ cần quản lý Googlebot, việc này đòi hỏi hiểu rõ không phải mọi bot AI đều tuân thủ robots.txt nghiêm ngặt như nhau, đặc biệt với các bot hoạt động theo yêu cầu trực tiếp của người dùng.
Mình là Đăng, làm Search Marketing cho khách hàng B2B tại SME Solution đã 6 năm. Trong bài trước mình đã liệt kê đầy đủ các loại LLM crawler hiện có. Bài này mình sẽ đi sâu vào cách cấu hình thực tế — cú pháp cụ thể, và quan trọng hơn, những cạm bẫy mà hầu hết hướng dẫn robots.txt cho AI bỏ qua.
Cú pháp cơ bản: cách chặn hoặc cho phép một bot cụ thể
Robots.txt vẫn dùng cú pháp chuẩn đã có từ lâu, chỉ khác ở việc chỉ định đúng tên user-agent của từng bot AI. Cấu trúc cơ bản:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ClaudeBot
Crawl-delay: 1
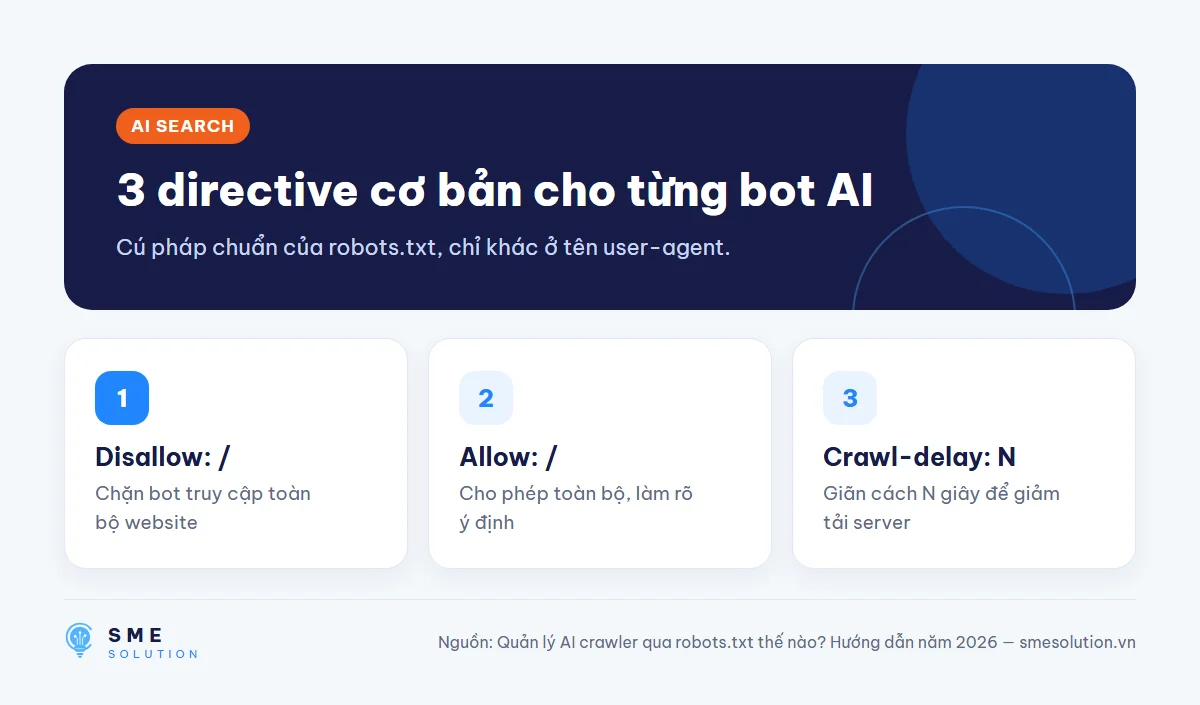
Ba directive quan trọng cần nắm:
Disallow: /— chặn hoàn toàn bot đó truy cập toàn bộ website.Allow: /— cho phép bot đó truy cập toàn bộ (thường dùng để làm rõ ý định khi có directive chung phía trên có thể gây nhầm lẫn).Crawl-delay: N— không chặn hoàn toàn, chỉ yêu cầu bot giãn cách N giây giữa các lượt truy cập, hữu ích khi muốn giảm tải server mà vẫn cho phép crawl (Anthropic khuyến nghị dùng directive này thay vì chặn hoàn toàn nếu lý do chính là tải server).
Mỗi loại bot cần một khối User-agent riêng — không thể dùng một directive chung để kiểm soát nhiều bot cùng lúc trừ khi dùng wildcard User-agent: *, vốn áp dụng cho mọi bot không được chỉ định riêng.
Cảnh báo quan trọng nhất: không phải bot nào cũng tuân thủ robots.txt
Đây là phần thông tin quan trọng nhất bài này, và là điều gần như mọi hướng dẫn robots.txt tiếng Việt về AI crawler đều bỏ sót. Theo chính tài liệu của các nhà cung cấp:
- Perplexity-User (khi người dùng hỏi trực tiếp về một trang cụ thể) — theo tài liệu Perplexity, bot này “generally ignores robots.txt rules”.
- ChatGPT-User (khi ChatGPT truy cập trang theo yêu cầu người dùng) — theo tài liệu OpenAI, “robots.txt rules may not apply” với loại truy cập này.
Lý do kỹ thuật: hai bot này không phải crawler thu thập hàng loạt, mà là hành động truy cập một trang cụ thể do một người dùng cụ thể yêu cầu trực tiếp — về bản chất tương tự việc người dùng đó tự copy URL vào trình duyệt để xem. Robots.txt vốn được thiết kế để kiểm soát hành vi thu thập dữ liệu quy mô lớn, tự động, không nhằm ngăn một người dùng đơn lẻ xem một trang công khai theo yêu cầu của chính họ.
Hệ quả thực tế cho doanh nghiệp B2B: nếu bạn chặn hoàn toàn PerplexityBot hoặc ChatGPT trong robots.txt với kỳ vọng nội dung “không bao giờ xuất hiện” trên các nền tảng này, kỳ vọng đó không hoàn toàn chính xác. Khi khách hàng tiềm năng chủ động hỏi AI về trang cụ thể của bạn (ví dụ dán link vào ChatGPT và hỏi “tóm tắt trang này”), khả năng cao AI vẫn truy cập được nội dung — bất kể directive robots.txt nói gì.
Phân biệt quan trọng thứ hai: Google-Extended không phải Googlebot
Sai lầm phổ biến thứ hai khi cấu hình robots.txt cho AI: nhầm lẫn giữa hai user-agent của Google. Theo tài liệu Google Search Central:
- Googlebot — crawler chính phục vụ Google Search, bao gồm cả AI Overviews (vì AI Overviews là một phần không tách rời của cách Search hoạt động hiện nay). Chặn Googlebot = mất toàn bộ khả năng xuất hiện trên Google Search và AI Overviews.
- Google-Extended — chỉ kiểm soát việc nội dung có được dùng để huấn luyện các mô hình Gemini Apps và Vertex AI trong tương lai hay không. Không ảnh hưởng đến việc index cho Search, không phải tín hiệu xếp hạng.
Một cấu hình phổ biến và hợp lý: cho phép Googlebot đầy đủ (muốn xuất hiện trên Search + AI Overviews), nhưng chặn Google-Extended (không muốn dữ liệu dùng huấn luyện Gemini Apps trong tương lai):
User-agent: Googlebot
Allow: /

User-agent: Google-Extended
Disallow: /
Cấu hình này hoàn toàn khả thi và không mâu thuẫn — vì hai user-agent này kiểm soát hai việc độc lập nhau.
Chiến lược đề xuất cho doanh nghiệp B2B: nên chặn bot nào, cho phép bot nào
Dựa trên phân tích ở trên, đây là khung quyết định thực chiến cho nội dung marketing B2B công khai (không áp dụng cho dữ liệu nội bộ nhạy cảm):
Nên cho phép (search/answering bot):
– OAI-SearchBot (ChatGPT Search)
– PerplexityBot (chỉ mục chung của Perplexity)
– Googlebot (Search + AI Overviews)
– Claude-SearchBot (kết quả search của Claude)
Cân nhắc theo mục tiêu (training bot):
– GPTBot, ClaudeBot, Google-Extended — chặn nếu muốn hạn chế nội dung độc quyền (báo giá, số liệu nội bộ, phân tích chuyên sâu) bị dùng huấn luyện mô hình miễn phí cho bên thứ ba; cho phép nếu ưu tiên độ phủ thương hiệu rộng nhất có thể, kể cả trong dữ liệu huấn luyện AI tương lai.
Không thể kiểm soát hoàn toàn dù chặn:
– ChatGPT-User, Perplexity-User — vì thường bỏ qua robots.txt khi có yêu cầu trực tiếp từ người dùng cụ thể.
Ví dụ file robots.txt hoàn chỉnh cho website B2B
User-agent: Googlebot
Allow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: PerplexityBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: ClaudeBot
Disallow: /

Sitemap: https://vidu-doanh-nghiep.vn/sitemap.xml
Cấu hình mẫu này ưu tiên tối đa hóa hiện diện trên AI search (cho phép mọi bot search/answering), đồng thời hạn chế việc dữ liệu bị dùng huấn luyện mô hình miễn phí (chặn các bot training) — phù hợp với phần lớn doanh nghiệp B2B muốn cân bằng giữa việc được tìm thấy và bảo vệ nội dung độc quyền.
Framework: 4 bước triển khai cho website chưa từng cấu hình

- Kiểm tra robots.txt hiện tại — xem có đang chặn nhầm wildcard
*ảnh hưởng cả bot cần thiết, hay hoàn toàn chưa có directive nào cho AI crawler. - Xác định mục tiêu ưu tiên — tối đa hiện diện AI search, hay ưu tiên bảo vệ dữ liệu không bị dùng huấn luyện, hay cân bằng cả hai theo mẫu ở trên.
- Viết directive theo đúng tên user-agent chính xác — sai chính tả tên bot (ví dụ viết “Gptbot” thay vì “GPTBot”) có thể khiến directive không có tác dụng.
- Xác minh qua công cụ kiểm tra robots.txt và log server, đối chiếu với danh sách IP chính thức nếu nghi ngờ có request giả mạo user-agent để vượt qua kiểm soát.
Là một đơn vị SEO ở Hà Nội, đây cũng là hạng mục bọn mình luôn kiểm tra khi audit kỹ thuật cho khách hàng — vì rất nhiều website B2B tại Việt Nam hiện vẫn chưa có bất kỳ directive nào riêng cho AI crawler, để mặc định hoàn toàn.
Lỗi thường gặp khi cấu hình robots.txt cho AI crawler
Ba lỗi phổ biến nhất bọn mình gặp khi audit robots.txt của khách hàng B2B:
Lỗi 1 — Chặn nhầm bằng wildcard quá rộng. Một số website dùng User-agent: * kèm Disallow: /some-path/ với ý định chặn một loại bot cụ thể, nhưng thực tế directive này áp dụng cho mọi bot không được khai báo riêng — bao gồm cả những bot search/answering mà doanh nghiệp thực ra muốn cho phép. Cách khắc phục: luôn khai báo riêng từng user-agent cụ thể trước, chỉ dùng wildcard * cho quy tắc mặc định áp dụng chung.
Lỗi 2 — Sai chính tả hoặc sai định dạng tên user-agent. Tên bot cần khớp chính xác từng ký tự với tài liệu chính thức (ví dụ “GPTBot” viết hoa đúng chuẩn, không phải “Gptbot” hay “gpt-bot”). Một lỗi chính tả nhỏ khiến toàn bộ directive vô hiệu mà không có cảnh báo lỗi nào hiển thị — bot vẫn tiếp tục crawl như thể không có directive nào tồn tại.
Lỗi 3 — Quên cập nhật khi có bot mới ra mắt. Ngành AI thay đổi nhanh — một cấu hình được coi là đầy đủ vào đầu năm có thể thiếu sót vài bot mới chỉ sau vài tháng, khi các nhà cung cấp AI tách nhỏ hoặc thêm crawler chuyên biệt hơn. Nên đặt lịch rà soát định kỳ (khuyến nghị mỗi quý) thay vì coi đây là việc làm một lần.
Cách xác minh cấu hình robots.txt đang hoạt động đúng
Sau khi cập nhật robots.txt, nên xác minh qua ba bước:
- Kiểm tra cú pháp bằng công cụ kiểm tra robots.txt (nhiều công cụ SEO miễn phí hỗ trợ việc này), đảm bảo không có lỗi cú pháp khiến toàn bộ file bị bỏ qua.
- Theo dõi log server trong 1-2 tuần sau khi thay đổi, xem các bot đã khai báo có thực sự tuân theo directive mới hay chưa — lưu ý độ trễ cập nhật có thể lên đến 24 giờ hoặc hơn tùy nhà cung cấp.
- Đối chiếu IP với danh sách chính thức nếu nghi ngờ có request giả mạo user-agent — vì về mặt kỹ thuật, bất kỳ ai cũng có thể tự đặt tên user-agent giống GPTBot mà không thực sự là bot của OpenAI, nên IP xác minh mới là bằng chứng đáng tin cậy hơn tên user-agent đơn thuần.
Câu hỏi thường gặp
Thay đổi robots.txt có hiệu lực ngay lập tức không?
Không hoàn toàn. Ví dụ OAI-SearchBot của OpenAI cần khoảng 24 giờ để hệ thống cập nhật theo thay đổi robots.txt mới — các nhà cung cấp khác có thể có độ trễ tương tự, không có cam kết cập nhật tức thời.
Có cần audit robots.txt định kỳ không?
Có, nên định kỳ vì danh sách bot AI liên tục thay đổi — các công ty AI thường xuyên ra mắt bot mới hoặc tách nhỏ chức năng bot hiện có, một cấu hình đúng hôm nay có thể thiếu sót sau vài tháng nếu không cập nhật.
Nếu không chắc nên chặn bot nào, có nên để mặc định không cấu hình gì không?
Không nên. Để mặc định đồng nghĩa cho phép mọi bot (kể cả bot huấn luyện) truy cập tự do — không phải lựa chọn trung lập mà thực chất là lựa chọn “cho phép tất cả” theo mặc định của giao thức robots.txt.
IP-based blocking có thay thế được robots.txt không?
Không nên dùng thay thế hoàn toàn. Theo tài liệu Anthropic, việc chặn theo IP có thể không đáng tin cậy vì nó ngăn cả việc bot đọc chính file robots.txt để tuân thủ directive — robots.txt vẫn nên là lớp kiểm soát chính, IP blocking chỉ nên dùng bổ sung khi nghi ngờ có request giả mạo.
Nguồn tham khảo
- OpenAI Bots — developers.openai.com
- Anthropic’s Web Crawlers — support.claude.com
- Perplexity Crawlers — docs.perplexity.ai
- AI Features and Your Website — Google Search Central
Chưa chắc file robots.txt hiện tại đã cấu hình đúng?
Nhắn Zalo cho SME Solution nếu bạn muốn bọn mình rà lại robots.txt hiện tại của website — xác định xem đang vô tình chặn nhầm bot cần thiết cho AI search, hay để hở bot huấn luyện mà bạn muốn kiểm soát.

