

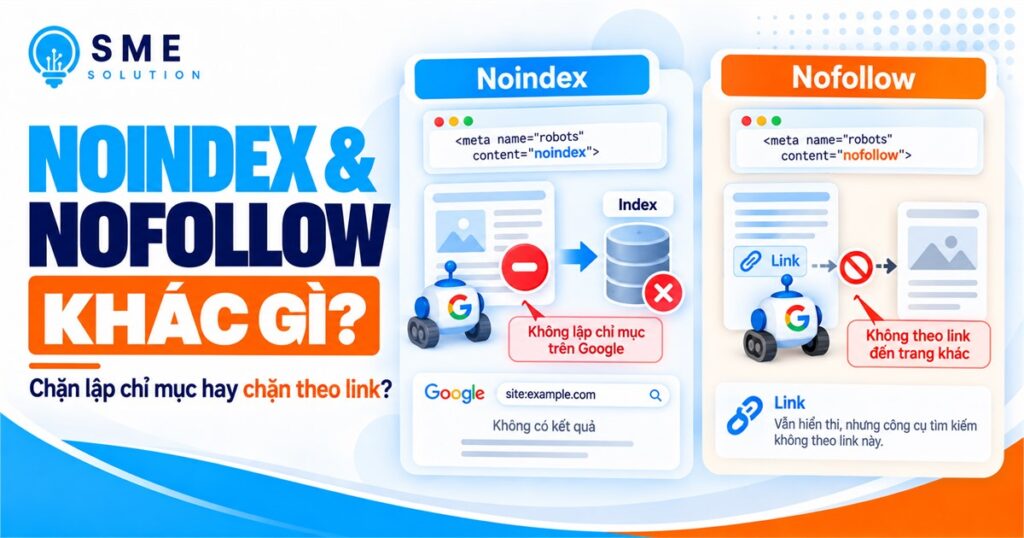
Noindex là chỉ định yêu cầu Google không đưa một trang vào chỉ mục tìm kiếm. Nofollow là chỉ định yêu cầu Google không truyền giá trị liên kết qua các link cụ thể trên trang đó. Hai chỉ định này giải quyết hai vấn đề hoàn toàn khác nhau, dù thường bị dùng lẫn lộn.
Mình là Đăng, làm Search Marketing cho khách hàng B2B tại SME Solution đã 6 năm. Bài này mình sẽ làm rõ một điểm hay gây nhầm lẫn nhất: noindex có thực sự giúp tiết kiệm crawl budget hay không.
Noindex là gì?
Noindex là chỉ định (đặt trong thẻ meta robots hoặc HTTP header) yêu cầu Google không lưu trang đó vào chỉ mục tìm kiếm — nghĩa là trang sẽ không xuất hiện trong kết quả tìm kiếm, dù người dùng có thể vẫn truy cập trực tiếp qua URL.
Nofollow là gì?
Nofollow là chỉ định (đặt ở cấp độ link cụ thể, hoặc cấp trang qua meta robots) yêu cầu Google không truyền giá trị liên kết (link equity) qua các đường link đó. Trang đích của link nofollow vẫn có thể được crawl và index bình thường qua các đường link khác — nofollow chỉ ảnh hưởng đến việc truyền giá trị qua đúng đường link đó.
Cơ chế: noindex vẫn cần Google crawl để hoạt động
Đây là điểm gây nhầm lẫn phổ biến nhất, đặc biệt khi mục tiêu là tiết kiệm crawl budget.
Nhiều người nghĩ đặt noindex sẽ giúp Google “bỏ qua” trang đó, tiết kiệm tài nguyên crawl. Thực tế ngược lại: Google vẫn phải crawl trang để đọc được chỉ định noindex trong code, sau đó mới quyết định không đưa vào index. Nói cách khác, noindex không tiết kiệm crawl budget — nó chỉ ngăn index, còn crawl vẫn diễn ra bình thường, thậm chí Google còn cần crawl lại định kỳ để xác nhận chỉ định noindex vẫn còn hiệu lực.
Nếu mục tiêu thực sự là tiết kiệm crawl budget (ví dụ với site rất lớn có hàng chục nghìn URL tham số không cần thiết), công cụ đúng là chặn crawl qua robots.txt — ngăn Googlebot truy cập trang đó ngay từ đầu, không tốn tài nguyên crawl. Nhưng lưu ý: robots.txt disallow không đảm bảo trang không xuất hiện trong kết quả tìm kiếm (Google vẫn có thể index URL dựa trên tín hiệu bên ngoài như backlink, dù không crawl được nội dung) — nên robots.txt và noindex phục vụ hai mục đích khác nhau, không thể thay thế nhau hoàn toàn.
Lịch sử: vì sao nofollow ra đời và cách nó bị lạm dụng
Hiểu bối cảnh lịch sử giúp lý giải rõ hơn cách nofollow hoạt động ngày nay. Google giới thiệu thuộc tính rel=”nofollow” vào ngày 18/1/2005, ban đầu với mục đích chống spam do người dùng tạo ra — thời điểm đó, kẻ spam thường để lại hàng loạt link trong phần bình luận blog/WordPress để thao túng thứ hạng, và nofollow cho phép quản trị viên “vô hiệu hóa” các link này mà không cần xóa bình luận.
Không lâu sau khi ra đời, nofollow bị giới SEO khai thác theo cách không đúng ý định ban đầu — kỹ thuật gọi là “PageRank sculpting” (điêu khắc PageRank). Trước một thay đổi thuật toán năm 2009, nếu một trang có 10 link đi ra và 5 trong số đó được gắn nofollow, toàn bộ giá trị PageRank sẽ dồn hết vào 5 link còn lại — nhiều SEO khai thác cơ chế này bằng cách chủ động nofollow các link nội bộ ít quan trọng để “dồn” nhiều PageRank hơn cho các trang có giá trị thương mại cao. Đến năm 2009, Matt Cutts (đại diện Google thời điểm đó) xác nhận Google đã thay đổi cách xử lý — các link nofollow từ đó vẫn tiêu tốn PageRank như link thường, chỉ là không truyền giá trị đó đi tiếp — chấm dứt hoàn toàn kỹ thuật PageRank sculpting.
Cập nhật 2019-2020: nofollow trở thành “gợi ý”, không còn là “chỉ thị” tuyệt đối
Đây là thay đổi quan trọng nhất trong lịch sử phát triển của nofollow, ảnh hưởng trực tiếp đến cách dùng đúng ngày nay. Vào ngày 10/9/2019, Google công bố cách tiếp cận mới cho việc đánh dấu link “nofollow”, chính thức có hiệu lực từ 1/3/2020: thuộc tính rel=”nofollow” không còn là chỉ thị bắt buộc mà trở thành một “gợi ý” (hint) cho hệ thống index — nghĩa là Google có thể vẫn quyết định crawl/dùng link đó cho mục đích xếp hạng nếu các tín hiệu khác đủ mạnh, dù đã gắn nofollow.
Cùng đợt cập nhật này, Google giới thiệu thêm hai thuộc tính chi tiết hơn: rel=”ugc” (User Generated Content — nội dung do người dùng khác thêm vào, ví dụ bình luận, diễn đàn) và rel=”sponsored” (đánh dấu rõ link là quảng cáo, nội dung tài trợ, hoặc affiliate). Cả hai thuộc tính mới này hoạt động tương tự nofollow về bản chất (không ngụ ý xác nhận/bảo chứng, không truyền giá trị xếp hạng), nhưng cung cấp thông tin chi tiết hơn về lý do gắn nofollow — giúp Google phân biệt rõ giữa link do chính chủ website cố ý gắn (ví dụ link tài trợ) với link do bên thứ ba tự thêm vào (bình luận, UGC) mà chủ site không kiểm soát hoàn toàn.
Bảng so sánh nhanh 3 công cụ
| Công cụ | Ngăn crawl? | Ngăn index? | Truyền link equity? |
|---|---|---|---|
| Noindex | Không | Có | Có (link trên trang vẫn truyền giá trị bình thường) |
| Nofollow (cấp link) | Không ảnh hưởng crawl trang đích qua link khác | Không | Không (qua đúng link đó) |
| Robots.txt disallow | Có | Không đảm bảo (có thể vẫn bị index dựa trên tín hiệu ngoài) | Không áp dụng |
Khi nào dùng công cụ nào
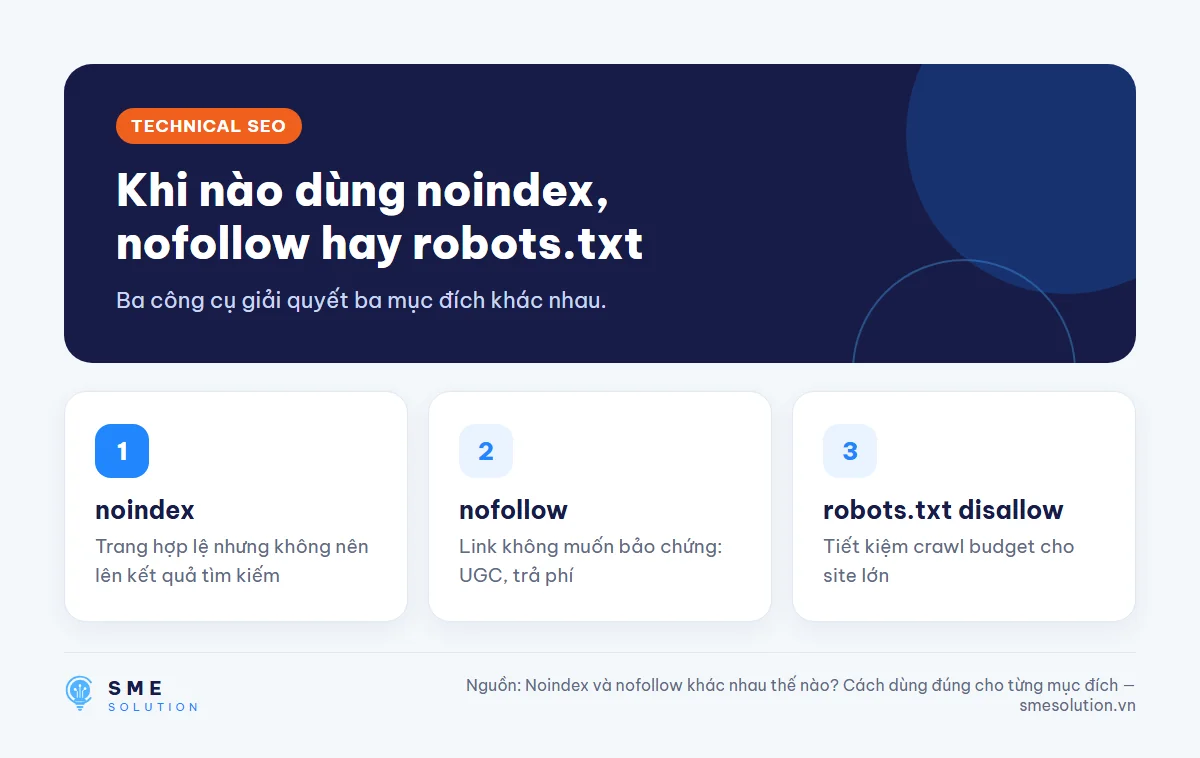
- Dùng noindex cho các trang tồn tại hợp lệ nhưng không nên xuất hiện trên kết quả tìm kiếm — trang cảm ơn sau form, trang kết quả tìm kiếm nội bộ, trang phân trang sâu ít giá trị.
- Dùng nofollow cho các link không muốn “bảo chứng” bằng uy tín của site — link đến nội dung do người dùng đăng (UGC), link trả phí/tài trợ (bắt buộc theo quy định của Google).
- Dùng robots.txt disallow khi mục tiêu chính là tiết kiệm crawl budget cho site lớn, chấp nhận việc URL có thể vẫn xuất hiện dạng “không có mô tả” nếu có tín hiệu bên ngoài mạnh.
Muốn hiểu sâu hơn về cơ chế crawl budget và cách Google phân bổ tài nguyên, xem thêm bài crawling và indexing là gì.
Khi nào bắt buộc phải dùng rel=”sponsored” thay vì nofollow thường
Với các website B2B có hợp tác nội dung trả phí (bài đăng tài trợ, guest post trả phí, hoặc affiliate link), việc dùng đúng thuộc tính không chỉ là thực hành tốt mà còn là yêu cầu tuân thủ chính sách của Google. Cụ thể, bất kỳ link nào phát sinh từ quan hệ tài chính (quảng cáo, bài viết được trả tiền để đăng, chương trình affiliate) đều bắt buộc phải gắn rel=”sponsored” — không dùng nofollow thông thường cũng không được, vì đây được coi là công bố minh bạch bắt buộc về bản chất thương mại của link đó. Vi phạm quy định này (để link quảng cáo tồn tại dưới dạng follow bình thường, hoặc chỉ nofollow chung chung không phân loại rõ) có thể bị coi là link thao túng, dẫn đến rủi ro bị đánh giá thủ công (manual action) từ Google.
Ví dụ minh họa cho website B2B: khi nào dùng đúng từng loại thuộc tính
Để áp dụng cụ thể, hãy xem một website B2B ngành cơ khí có nhiều loại link khác nhau xuất hiện tự nhiên trong quá trình vận hành: link trong phần bình luận blog do khách truy cập để lại nên gắn rel=”ugc” (nội dung người dùng tự thêm, chủ site không kiểm soát nội dung); link trong một bài viết được đối tác trả phí để đăng giới thiệu sản phẩm nên gắn rel=”sponsored” (rõ ràng có yếu tố thương mại); link dẫn đến một nguồn tham khảo không hoàn toàn tin tưởng (ví dụ một diễn đàn công khai không kiểm duyệt) có thể gắn nofollow thông thường (không phải UGC, không phải tài trợ, chỉ đơn giản không muốn “bảo chứng” bằng uy tín site); và link dẫn đến các nguồn nghiên cứu, số liệu gốc đáng tin cậy nên để follow bình thường, không gắn bất kỳ thuộc tính hạn chế nào — vì đây chính xác là loại link giúp tăng tín hiệu E-E-A-T qua việc trích dẫn nguồn uy tín.
Sai lầm thường gặp
- Dùng robots.txt để chặn crawl trang đã có noindex, khiến Google không crawl lại được để xác nhận noindex — nghịch lý này có thể khiến trang vẫn xuất hiện trong kết quả tìm kiếm (không có mô tả) dù mục tiêu ban đầu là ẩn hoàn toàn.
- Nghĩ noindex giúp tiết kiệm crawl budget — như đã giải thích, hiệu ứng ngược lại mới đúng.
- Nofollow toàn bộ outbound link “cho an toàn”, kể cả link đến nguồn tham khảo uy tín thực sự — làm giảm giá trị E-E-A-T vì thiếu tín hiệu trích dẫn nguồn đáng tin cậy.
FAQ
Noindex và robots.txt disallow có thể dùng cùng lúc không?
Không nên — nếu robots.txt chặn crawl, Google không đọc được chỉ định noindex trong trang, khiến chỉ định đó vô hiệu. Chỉ chọn một trong hai theo đúng mục đích.
Nofollow có ảnh hưởng đến toàn bộ trang hay chỉ từng link?
Có thể áp dụng ở cả 2 cấp: thuộc tính rel="nofollow" trên từng thẻ <a> cụ thể, hoặc <meta name="robots" content="nofollow"> áp dụng cho toàn bộ link trên trang.
Trang đã noindex có cần xóa khỏi sitemap không?
Nên xóa — giữ trang noindex trong sitemap gửi tín hiệu mâu thuẫn cho Google (sitemap thường dùng để báo hiệu “đây là trang quan trọng cần index”), dù không gây lỗi nghiêm trọng.
Vì sao nofollow từ “chỉ thị” đổi thành “gợi ý” lại quan trọng với người làm SEO?
Vì điều này có nghĩa việc gắn nofollow không còn đảm bảo tuyệt đối 100% rằng Google sẽ bỏ qua hoàn toàn link đó cho mục đích xếp hạng — với các tín hiệu đủ mạnh khác, Google vẫn có thể tham khảo link nofollow khi crawl và đánh giá, dù không dùng để truyền giá trị xếp hạng trực tiếp như trước đây.
Không gắn đúng rel=”sponsored” cho link quảng cáo có rủi ro gì?
Có rủi ro bị Google coi là link thao túng vi phạm nguyên tắc quản trị website, có thể dẫn đến hình phạt thủ công (manual action) nếu bị phát hiện — đây là lý do các website có nội dung tài trợ/quảng cáo cần đặc biệt cẩn trọng gắn đúng thuộc tính ngay từ đầu, không chỉ dùng nofollow chung chung.
Nguồn tham khảo
- Google Search Central, “Robots Meta Tags Specifications”
- Lumar, “Noindex, Nofollow & Disallow: How to Use SEO Indexing & Crawling Directives”
- Ahrefs, “The State of Nofollow, UGC, & Sponsored Link Attributes”
Website của bạn có đang dùng nhầm noindex, nofollow hoặc robots.txt cho cùng một mục đích, gây tín hiệu mâu thuẫn? Dịch vụ SEO Audit tại SME Solution kiểm tra kỹ toàn bộ chỉ định crawl/index trên site.

